都在抢GPU,为什么CPU也不够用了?
当 AI 从生成答案走向执行任务,算力瓶颈也在移动。沿着智能体的工作链条,看 CPU 需求为何上升,以及短缺能否持续。
AI算力的抢购清单上,CPU正变得越来越显眼。
9月底,渠道消息称,AMD第六代EPYC处理器Venice的2027年产能已被预订,订单开始排向2028年。这一说法尚未获得AMD官方确认,但服务器CPU的供给压力已经引起关注。消息来源
英特尔也发出了紧缺信号。据媒体对Splunk .conf26的报道,公司CEO表示,目前只能满足客户约一半的CPU需求。这一数字不能直接换算成全球缺口,但英特尔二季度正式披露已确认需求超过可供给数量,并预计基板、内存等关键部件的行业性短缺将持续至2027年。发言报道;英特尔季度报告
理解这轮变化,需要看清AI正在接手什么工作。生成一段答案,与完成一项任务,对算力的要求很不一样。
当AI开始替人执行任务,CPU承担的工作也随之增加。
一、GPU算得再快,也得等其他环节
让一个编程智能体修复错误,它要做的远不止生成几行代码。
它需要读取项目、提出方案、修改文件,再启动环境、编译、运行测试。如果测试失败,就把报错交回模型,修改后再试。
模型计算主要依靠GPU,代码执行和大量工具工作依靠CPU。一次任务要在这些环节之间往返,交付速度取决于整条流程。
算一笔简化的时间账:假设完成一项任务原本需要100秒,其中模型计算占90秒,其他暂时无法加速的步骤占10秒。
| 环节 | GPU升级前 | 模型计算提速10倍后 |
|---|---|---|
| 模型计算 | 90秒 | 9秒 |
| 其他步骤 | 10秒 | 10秒 |
| 总耗时 | 100秒 | 19秒 |
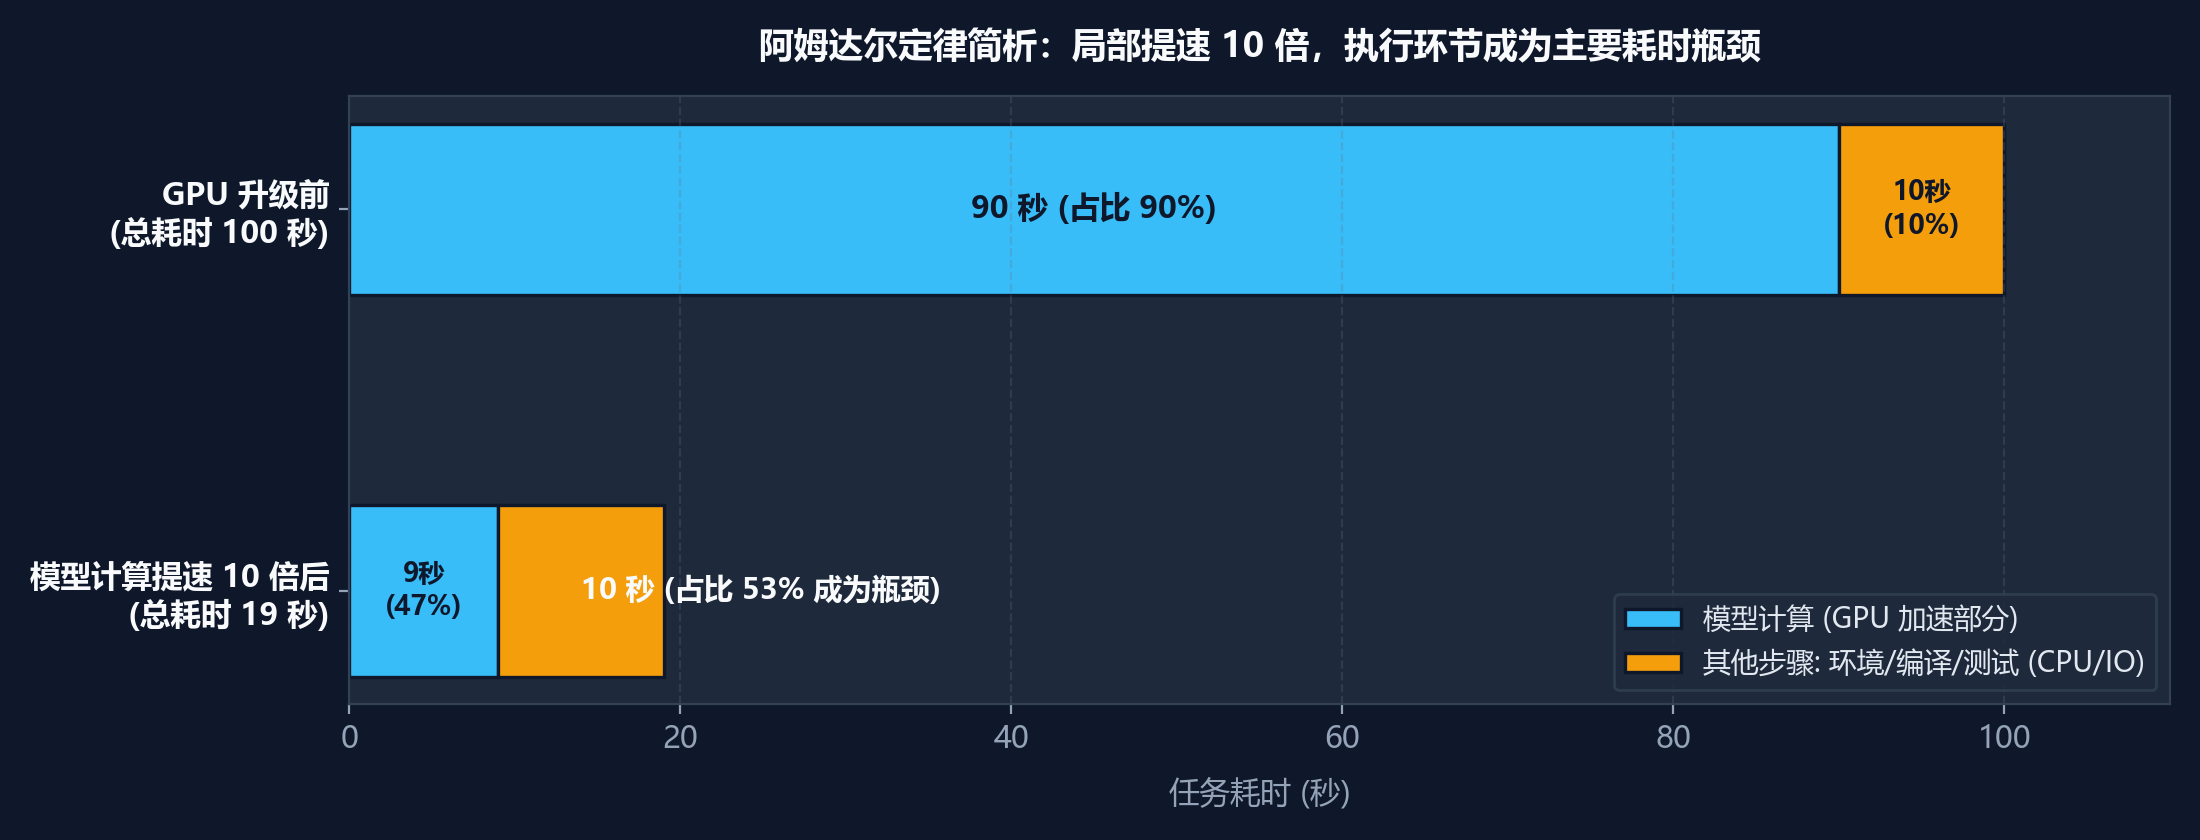
GPU负责的部分快了10倍,整项任务只快了约5.3倍。原来占十分之一的其他步骤,此时已经占去超过一半的时间。
这就是阿姆达尔定律揭示的约束:任务规模固定时,局部加速的收益,会受到剩余步骤的限制。表中的数字用于说明机制,并非真实智能体的平均耗时。英伟达CUDA最佳实践指南
但瓶颈更突出,还不等于CPU需求一定增长。每天只处理同样数量的任务,GPU升级可能只是缩短等待;网络延迟、磁盘访问和串行依赖,也未必能靠增加CPU解决。
真正推动采购的是下一步:企业把释放出来的GPU能力,用来同时处理更多任务。更多代码需要编译,更多测试需要运行,更多执行环境需要启动,CPU的总工作量才随之上升。
二、一个人提问,一群智能体干活
智能体正在把这一步变成现实。
人和聊天机器人对话,通常需要停下来读答案、想一想,再继续提问。人的阅读和判断速度,会限制请求频率。
智能体收到一个目标,可以自行执行多轮“规划—调用工具—检查结果—重试”。一次修复要求,可能触发几十次测试;一项资料整理任务,可能带来大量网页访问和数据库查询。多个智能体还可以同时执行不同的子任务。
用户只交代了一件事,后台可能已经运行了许多轮计算与工具调用。
这种扩张依然受到预算、权限和成功率的限制。企业愿意持续运行智能体,前提是完成工作的收益能够覆盖调用、执行和复核成本。一旦这个条件成立,CPU负载就不再只由人的提问次数决定,还取决于每项任务需要多少次尝试、多少个执行环境。
训练智能体也会增加这类需求。模型学习写代码、使用工具,需要反复尝试并检验结果,许多工具和环境运行在CPU上。
英伟达在2026年3月发布Vera CPU时,介绍了一种配备256颗CPU、可支持超过22500个并发CPU环境的机架。按照厂商披露的设计,这些资源服务于大规模执行与训练环境。Vera CPU发布公告
TrendForce也预计,智能体部署中的CPU与GPU数量配比,将从传统大模型场景的1∶4至1∶8,向1∶1至1∶2变化。这个判断针对特定部署场景,反映的是执行工作增加之后,硬件配置需要重新调整。TrendForce分析
三、CPU能加单,产能却不能立刻加速
需求的变化,遇上了供给扩张的时间差。
AMD已宣布Venice在台积电2纳米工艺上爬坡。新一代CPU同样需要先进制程资源,而晶圆制造只是交付的第一步,后面还有封装、基板、内存和整机配套。AMD量产爬坡公告
任何一环缺货,都可能让已经造出来的芯片无法及时变成可用服务器。英特尔披露的基板和内存约束,正说明供给压力已经延伸到处理器之外。英特尔季度报告
更多执行环境还需要更多内存容量、带宽,以及电力与散热支持。增加CPU采购量,实际上也在给整套配套设施增加订单。
企业可以很快提高软件端的并发需求,硬件厂商却要增加设备、提高良率、协调部件,再完成平台验证。采购计划与可交付的计算能力之间,隔着一段无法跳过的时间。
这段时间有多长,要看具体瓶颈。现有产线调整、新品放量和供应商扩产都可能缓解紧张,也都需要接受实际交付的检验。
四、同一座数据中心,可能需要更多CPU
CPU需求有多大,还取决于数据中心里运行的是什么任务。
Arm在2026年3月的演讲中估算,传统AI数据中心每吉瓦对应约3000万CPU核心,智能体场景可能提高至1.2亿核心。这是厂商对特定场景的测算,包含与加速器相邻的CPU资源,并非所有数据中心的统一标准。Arm演讲原文,第3—4页
借用这两个端点,可以做一个简单的敏感性分析。
假设新增投运的AI容量为G吉瓦,其中采用高CPU需求智能体配置的容量占比为p。采用线性插值,新增核心需求可以写成:
新增CPU核心需求 = G ×(3000万 + 9000万 × p)
以假设的10吉瓦新增容量为例,结果如下:
| 高CPU需求智能体配置占比 | 所需CPU核心 | 按每颗128核折算 |
|---|---|---|
| 10% | 3.9亿 | 约305万颗 |
| 30% | 5.7亿 | 约445万颗 |
| 60% | 8.4亿 | 约656万颗 |
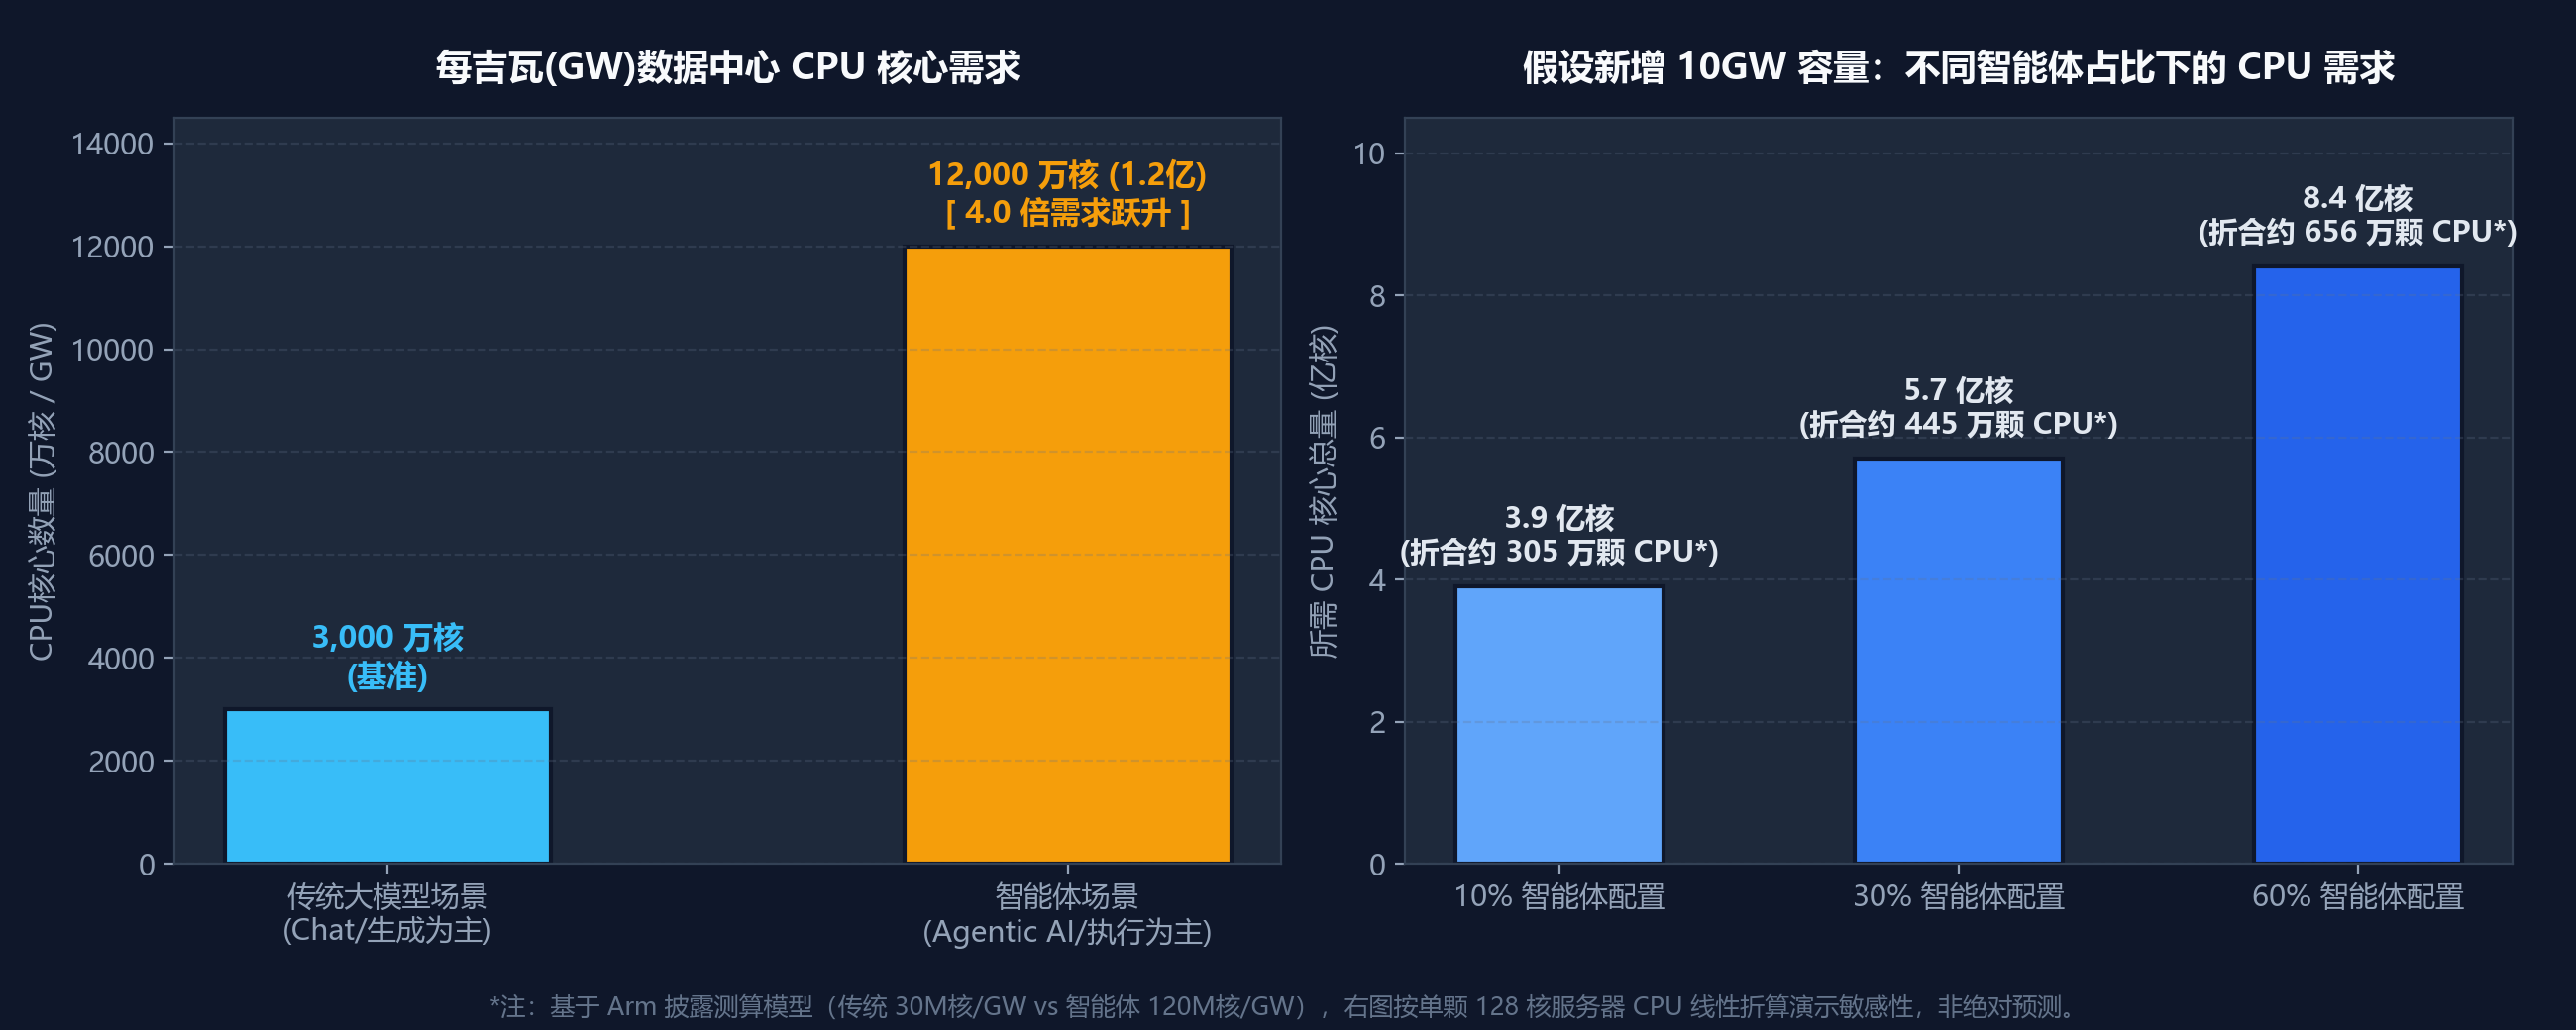
这里的10吉瓦、配置占比、线性插值和128核换算,都用于展示情景,不代表年度预测或行业平均配置。不同架构的核心也不能完全等量替代。
这笔账揭示的关键是:即使新增容量相同,仅任务结构变化,就可能让CPU需求相差一倍以上。
要进一步计算全球缺口,还需要加入通用服务器更新、既有AI设施升级和设备复用,再与各厂商的实际有效供给比较。目前公开数据还不足以填齐这张账本。
因此,2027年新品集中放量能否缓解紧张,取决于供给增加的同时,每座数据中心的CPU需求又提高了多少。判断未来是否平衡,必须同时看扩产速度、任务结构和软件效率。
五、短缺能持续多久,要看AI接到了多少真活
预订火热,需要最终使用需求来兑现。
客户担心拿不到货,可能提前采购,甚至重复下单。交期越长,囤货动机越强。如果实际任务增长没有跟上,今天的预订也可能变成明天的库存和砍单。
软件效率同样会改变需求。减少无效重试、复用执行环境、合并查询,都能降低完成一项任务所需的CPU资源。数据中心建设放缓,也会压低新增采购。
观察这轮短缺,可以抓住三个信号:
- 交期:同类服务器CPU的交付时间,是否持续拉长。
- 量价:厂商收入增长中,有多少来自实际出货,有多少来自高端产品占比提高和涨价。
- 使用:云厂商的建设与采购计划,是否转化为投运容量和持续运行的任务。
量价尤其容易被混淆。英特尔二季度服务器平均售价同比提高48%,出货量提高9%,并披露售价增长主要来自高端产品占比提升。收入增长很快,未必意味着卖出的CPU同样多,更不能直接换算成市场缺口。英特尔季度报告
CPU重新受到关注,背后是AI工作范围的扩大。模型能够提出更多方案之后,还需要系统执行代码、调用工具、读取数据、检查结果。企业真正购买的,是这些环节共同交付的一项工作。
CPU短缺能否持续,最终取决于企业愿意付钱交给AI完成的工作,能否增长得比整套基础设施更快。